01 ИИ · RAG · 4 месяца
ИИ-помощник
50 сотрудников спрашивают ИИ, а данные не покидают серверы компании
- Клиент
- Дистрибьютор строительной техники с филиалами в регионах
- Срок
- 4 месяца
- Услуги
- Модель Qwen на сервере компании, база знаний по документам, вход по учётной записи и API
- Доступ
- По ролям: сотрудник, руководитель филиала, директор

01 / В цифрах
- ≈50сотрудников работают с помощником
- 3уровня доступа: сотрудник, руководитель филиала, директор
- 4 мес.2 на настройку, 2 на наполнение базы
02 / Задача
- Было
Знания о технике, продажах и контрагентах лежали в тысячах файлов, ответ искали вручную.
- Нужно
Единая база с доступом по ролям и без передачи данных во внешние ИИ-сервисы.
03 / Решение
Один вопрос вместо поиска по папкам
- 01
Единая база знаний
Продажи, техника и контрагенты в одной базе. Финансовые показатели осознанно не включали.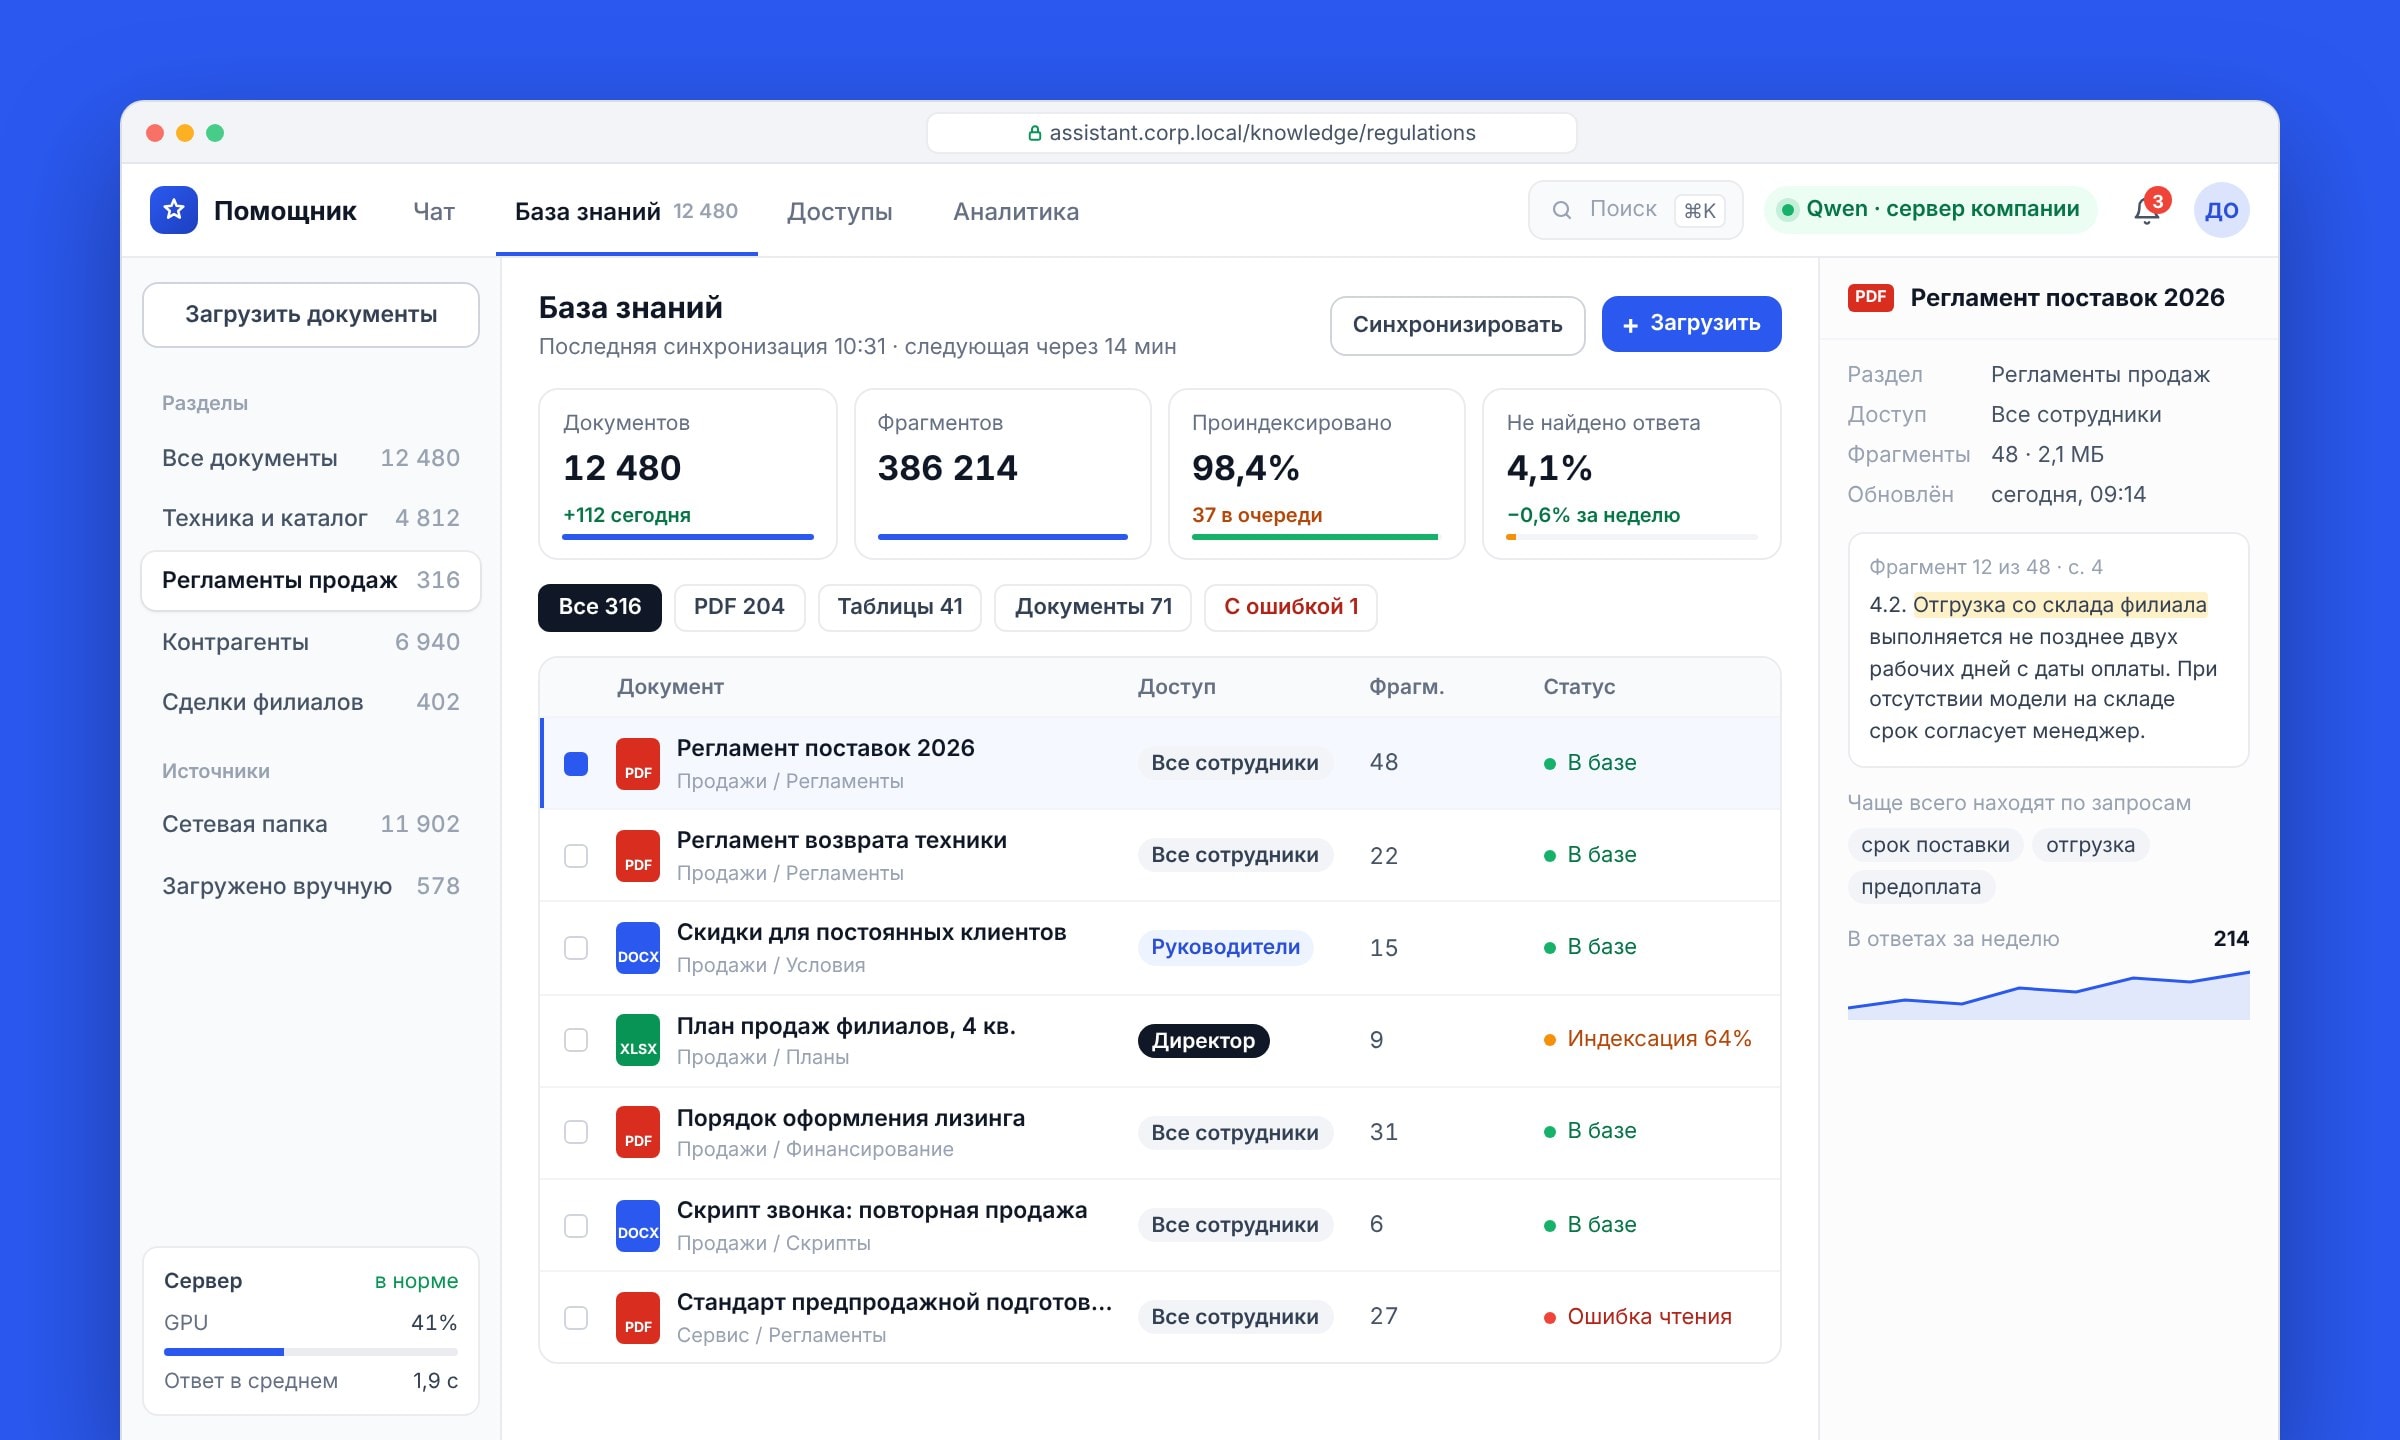
Данные условные - 02
Ответы обычным языком
Сотрудник спрашивает и сразу получает ответ со ссылкой на документ.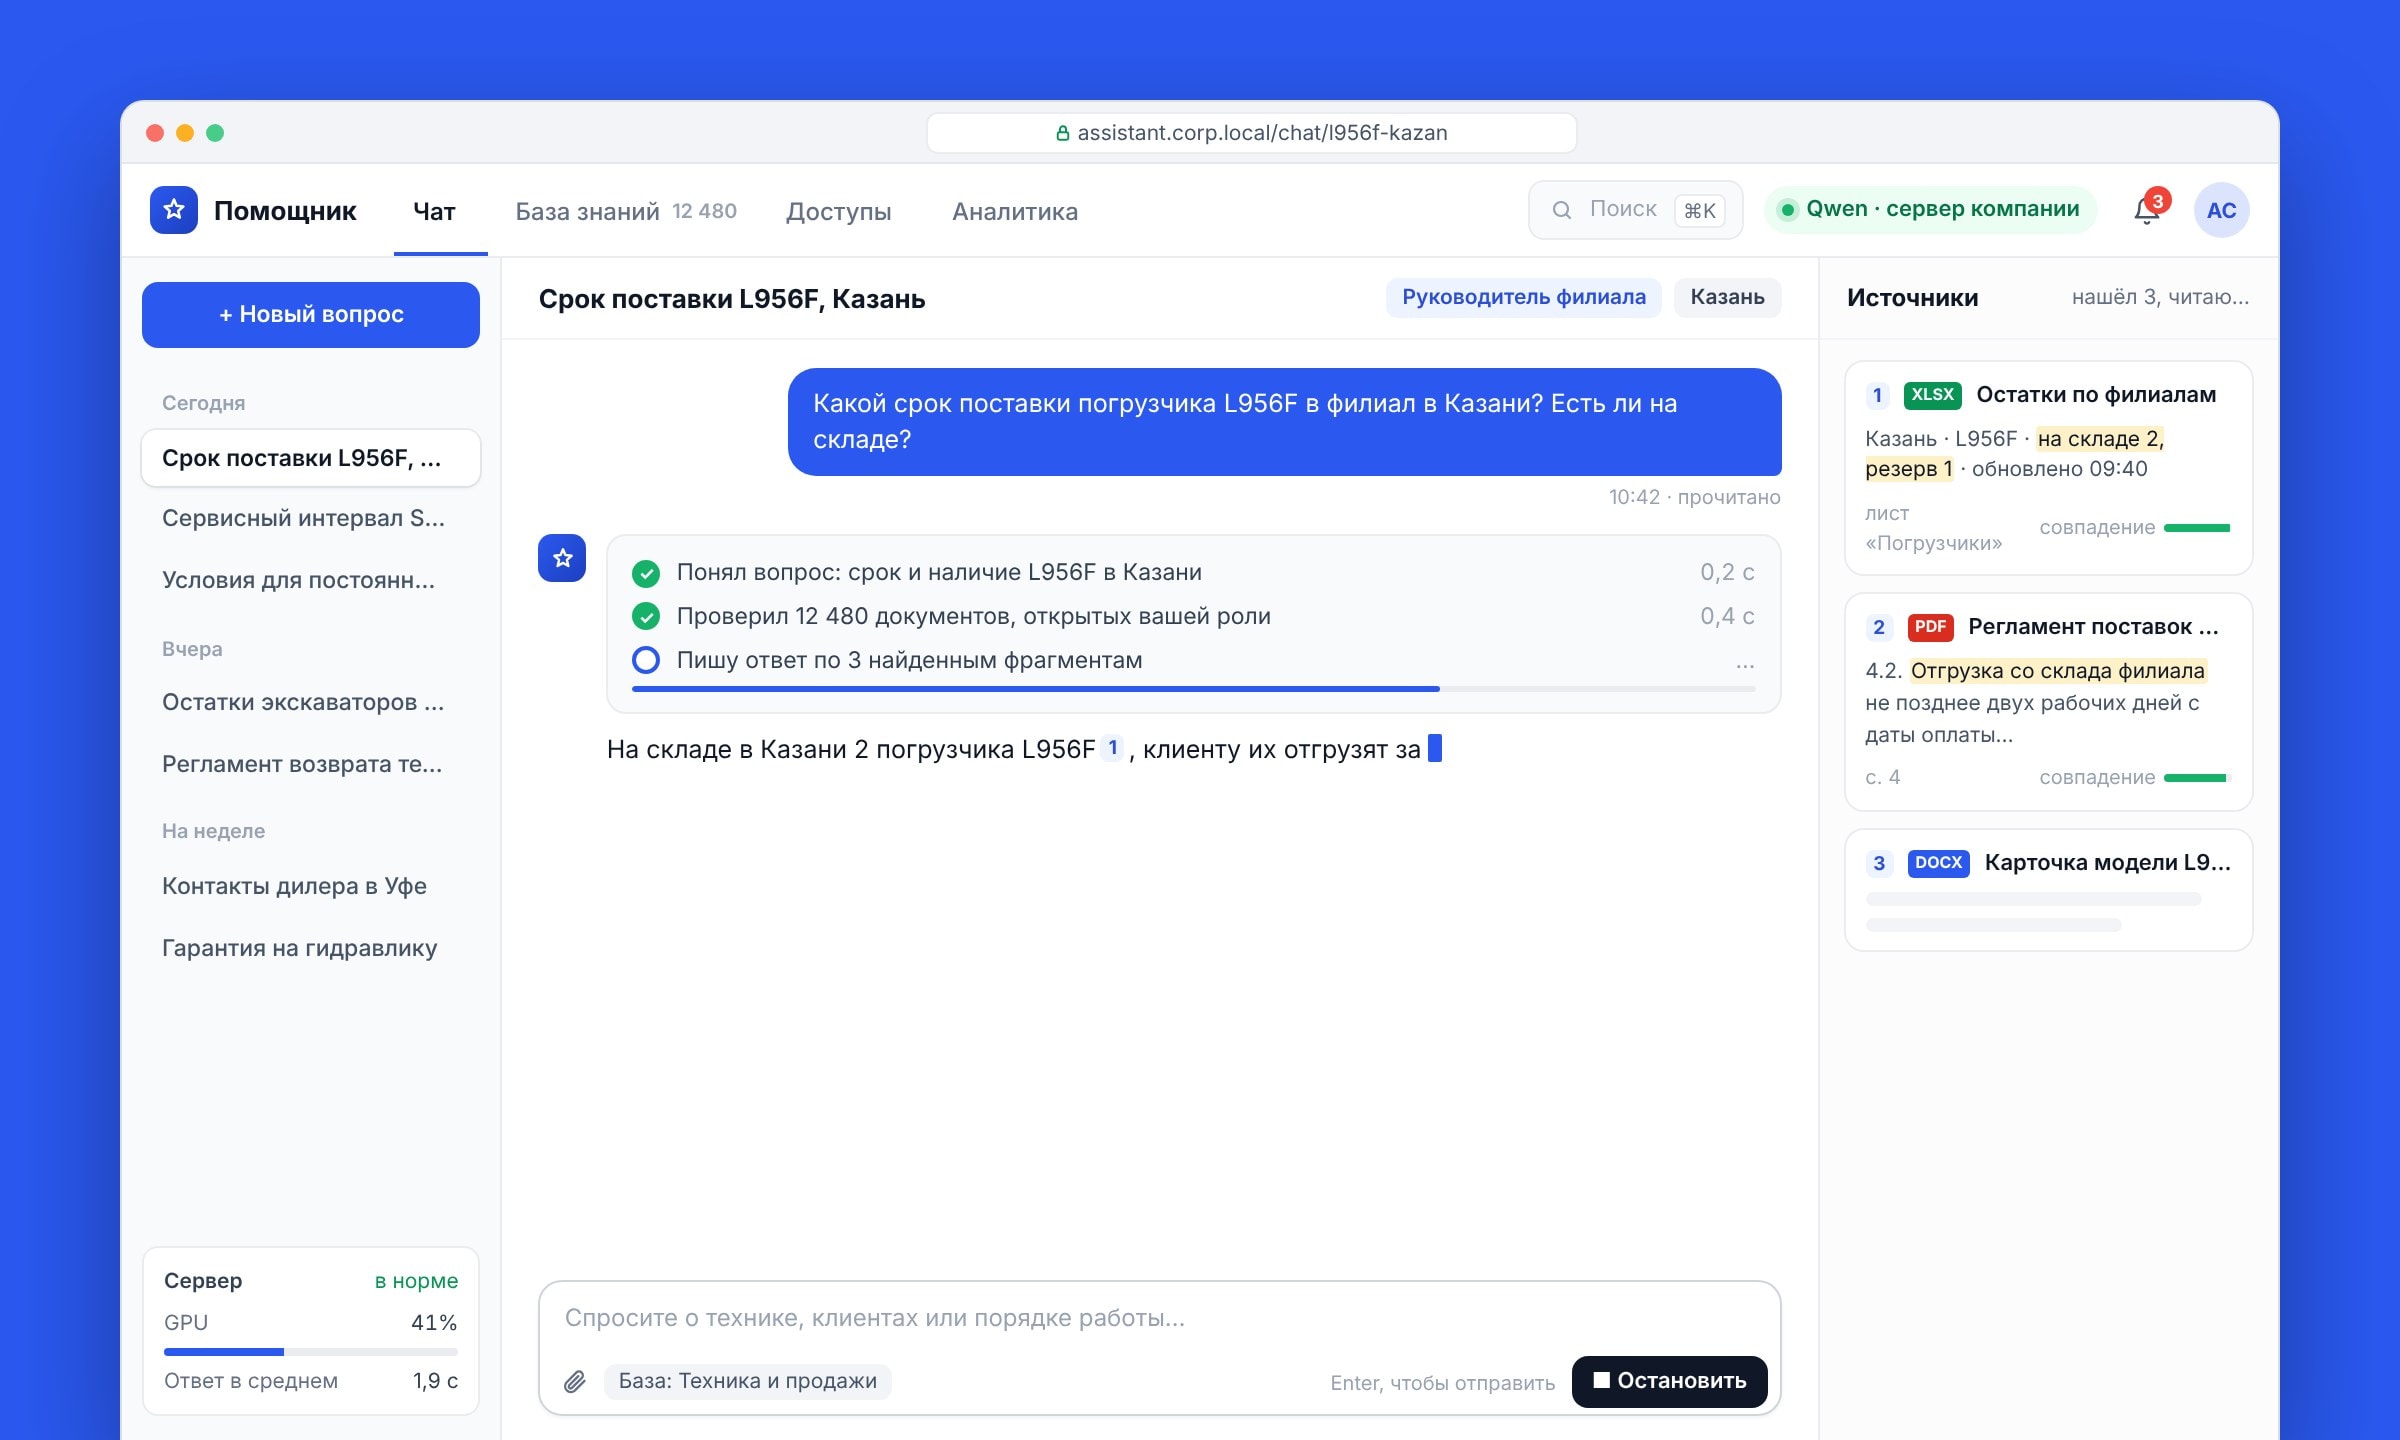
Данные условные - 03
Три уровня доступа
Сотрудник, руководитель филиала и директор получают ответы только из открытых им данных.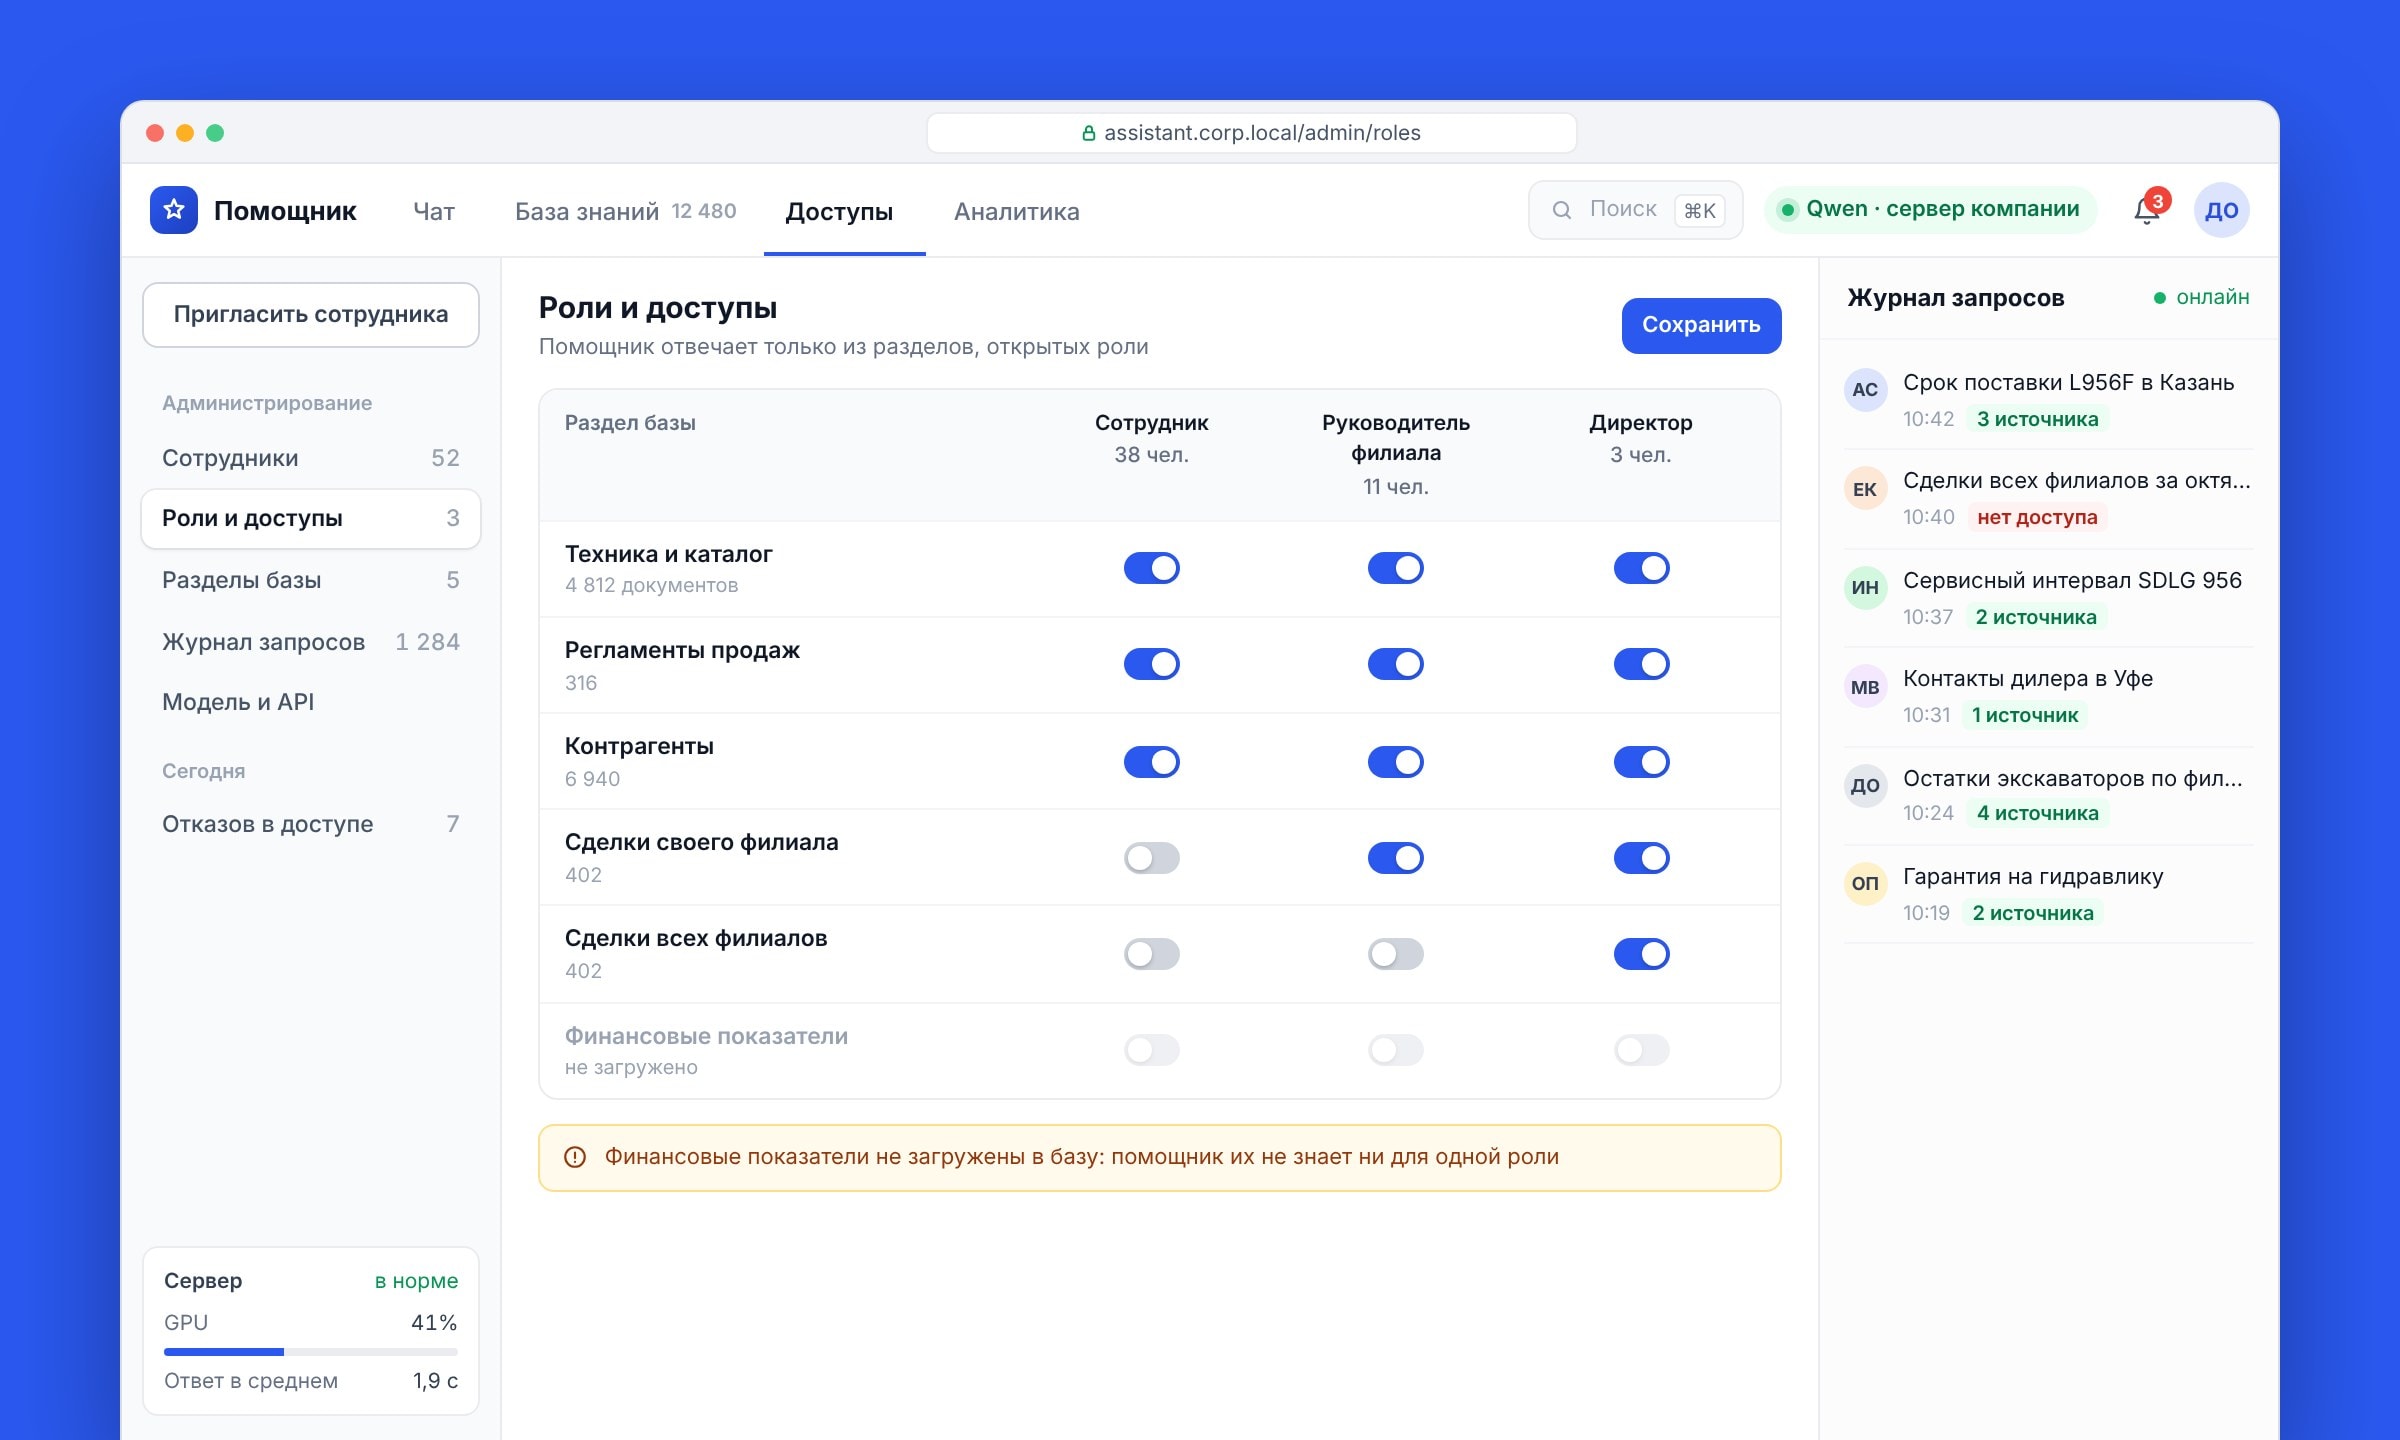
Данные условные


- 04
Модель на серверах заказчика
Открытая модель Qwen, данные не уходят в ChatGPT и другие внешние сервисы. - 05
API и интерфейс
Вход по учётной записи, API к модели для доработок.
04 / Как устроено
Модель работает внутри компании
- Документы
- База знаний
- Qwen
- Интерфейс
- Хватает одного сервера с видеокартой
- Финансовых показателей в базе нет
- Открытая LLM Qwen
- RAG
- API
- Свои серверы
05 / Выбор модели
Почему Qwen, а не самая сильная модель
Берём модель, которая помещается на ваш сервер, хорошо понимает русский и разрешена для коммерции.
- Qwen3.8-27BБерём сейчасГде запускаетсяОдин сервер с видеокартой на 24 ГБЛицензияApache 2.0Чем сильнаЛучшая открытая модель размером до 40B, хорошо работает с русским
- Gemma 4 31BГде запускается32–48 ГБ памятиЛицензияApache 2.0Чем сильнаВызов инструментов, общие задачи
- GPT-OSS 20BГде запускается16–24 ГБ памятиЛицензияApache 2.0Чем сильнаРассуждения и повседневные задачи
- DeepSeek V4.1 FlashГде запускаетсяСервер на 4–8 GPU, около 614 ГБ видеопамятиЛицензияMITЧем сильнаСильнее Qwen в автоматизации задач, но железо дороже в десятки раз
- ≈17 ГБвесит Qwen3.8-27B в сжатом виде, 4 бита
- 56токенов в секунду: скорость ответа одному сотруднику на одной RTX 3090
- 224токена в секунду суммарно, когда спрашивают четверо сразу
Честно о границах
- Открытые модели пока слабее лучших закрытых: по индексу Artificial Analysis разрыв около 12 баллов.
- У Qwen слабые общие знания, поэтому помощник отвечает только по базе знаний компании, а не из головы.
- Для чата снижаем глубину рассуждений: на максимуме модель думала над простой задачей 21 минуту.
Данные на ноябрь 2026: индекс Artificial Analysis v5, замеры скорости на vLLM.
06 / Результат
- 01Около 50 сотрудников работают с помощником
- 02В компании появилась единая база знаний
- 03От старта до работы всей компании 4 месяца
07 / Заявка
Нужен ИИ-помощник?
Пары строк достаточно. Ответит CTO в течение рабочего дня.